Zainstaluj
Joshuę
curl -fsSL https://ask.joshua.earth/install.sh | bash
Wklej to w Terminalu. Potrzebny jest Mac z procesorem Apple (M1 lub nowszy) albo pecet z Linuksem, 8 GB pamięci i 10–40 GB wolnego miejsca na dysku. Na Linuksie karta graficzna NVIDIA bardzo go przyspiesza. Bezpłatny i otwarty.
Jedna linijka, kilka pytań
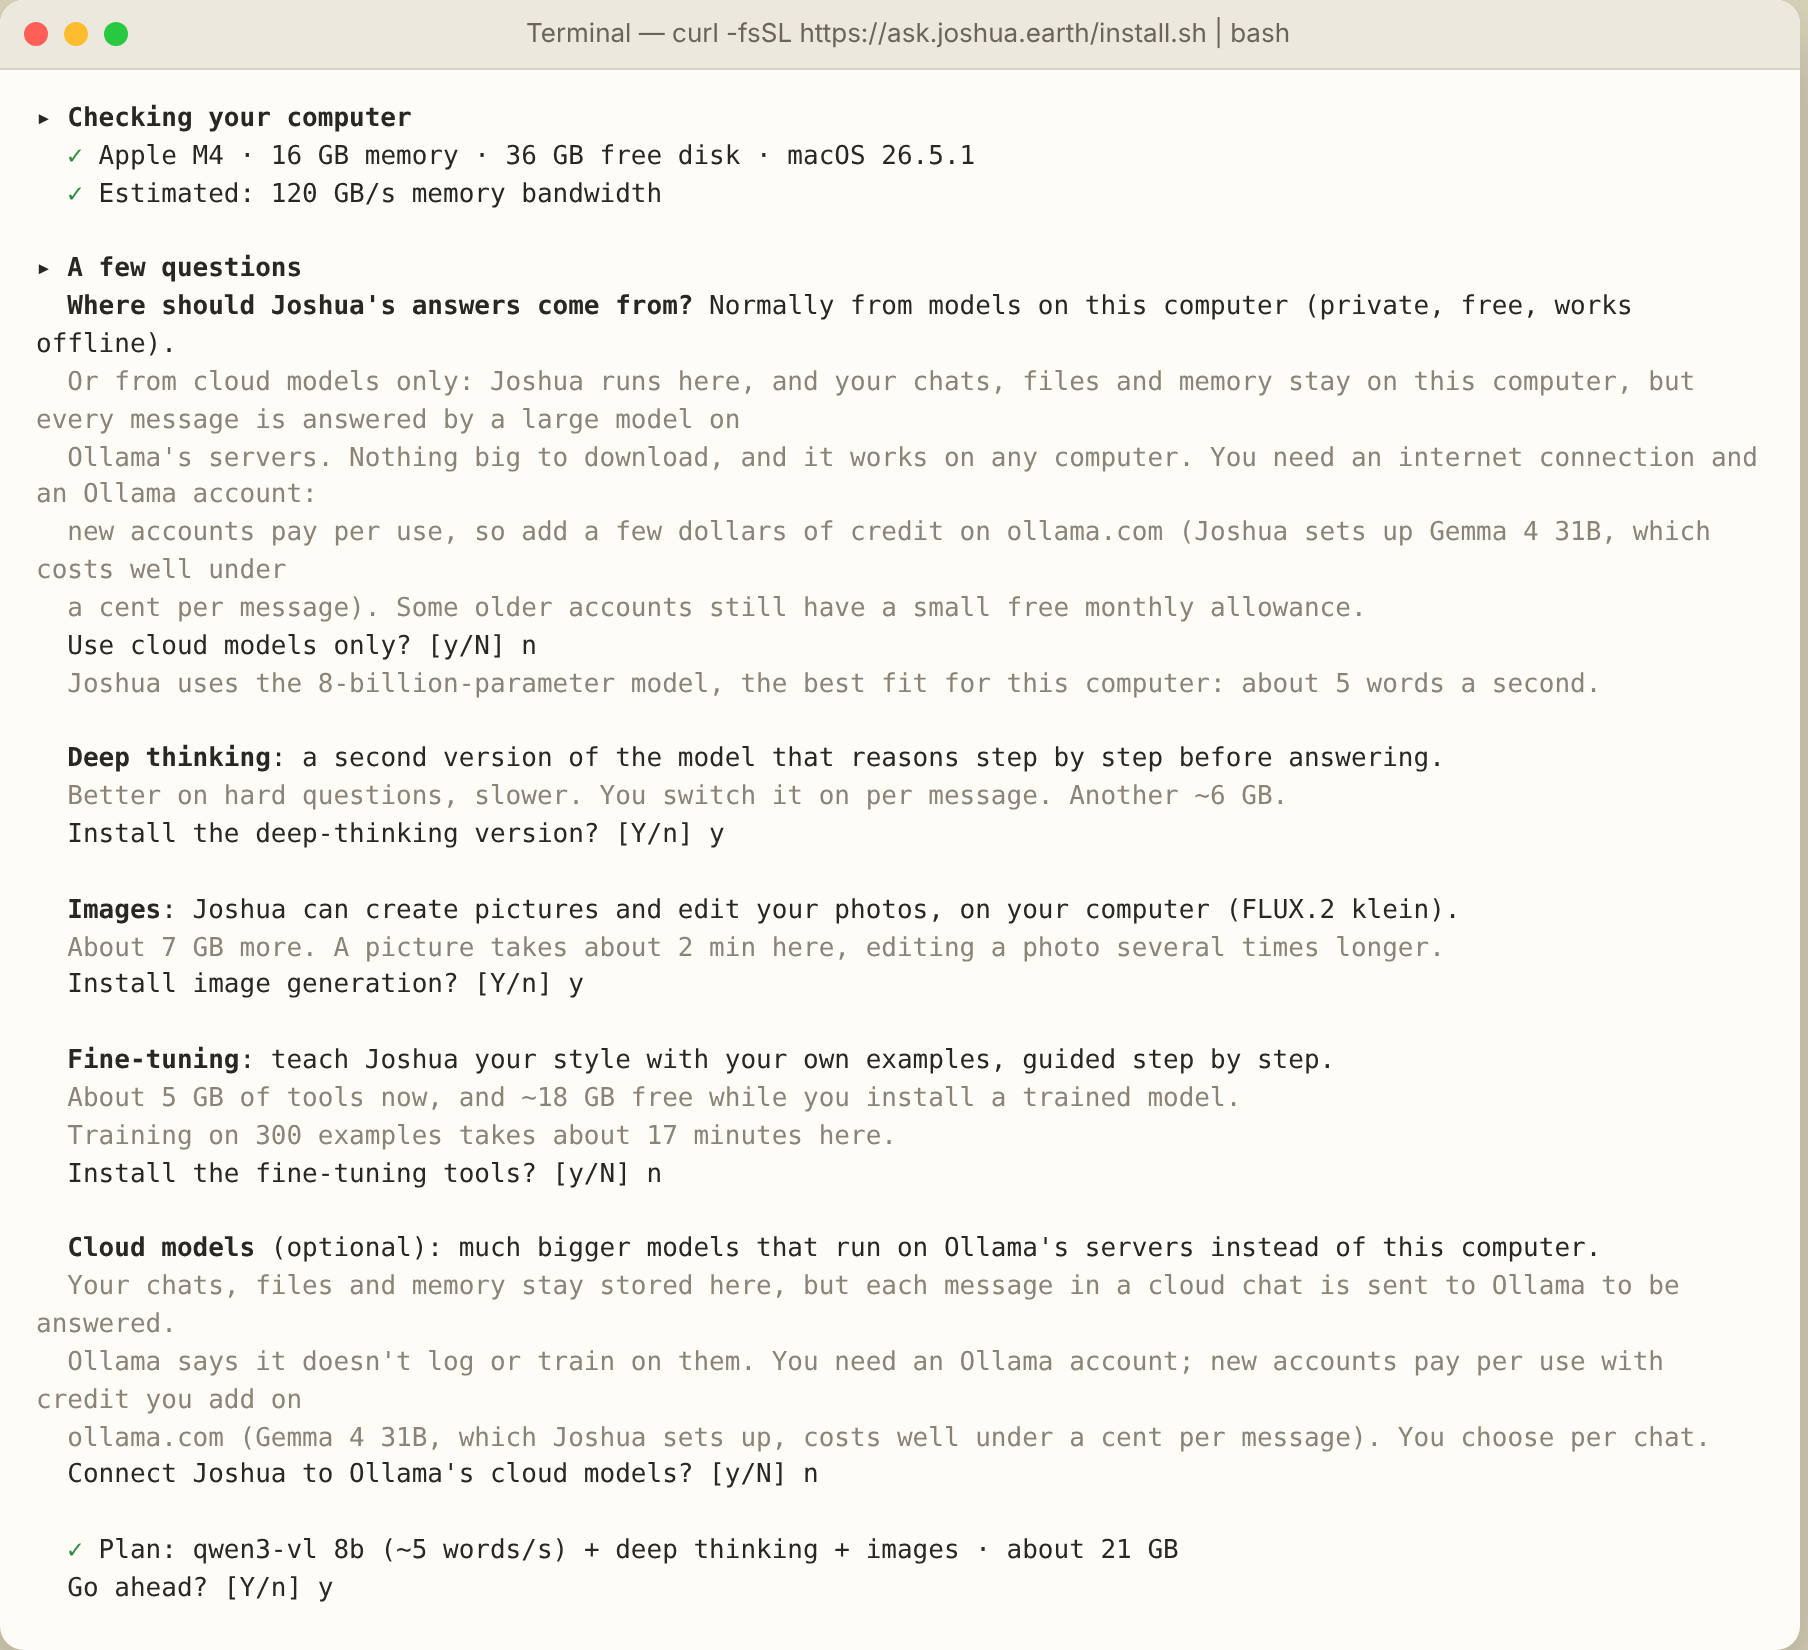
Najpierw instalator ogląda twój komputer: procesor, kartę graficzną, pamięć, wolne miejsce, i szacuje, jak szybko działałby każdy model. Pyta, czy chcesz głębokie rozumowanie, obrazy i fine-tuning, czy tylko modele w chmurze, pokazuje plan i potrzebne miejsce, i czeka na twoje „tak”.
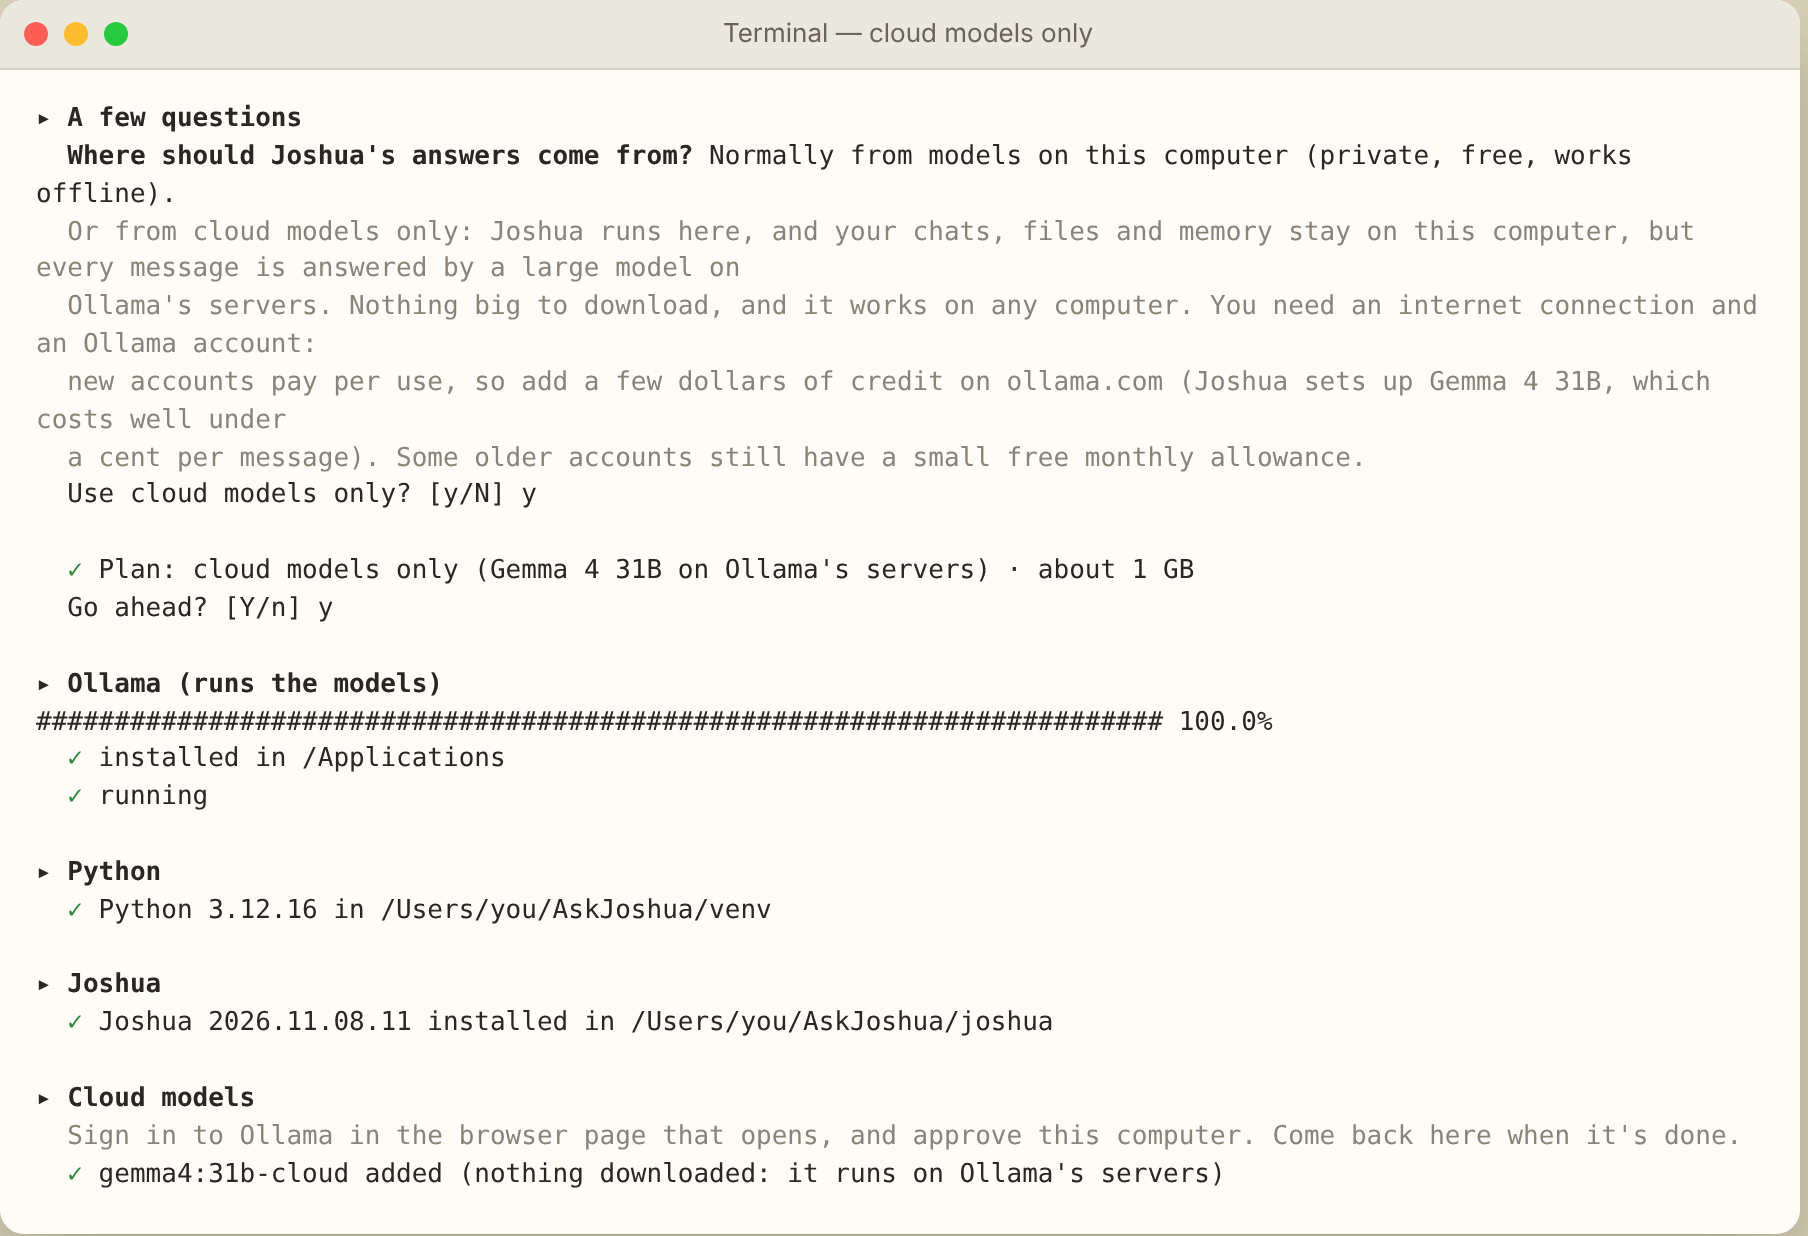
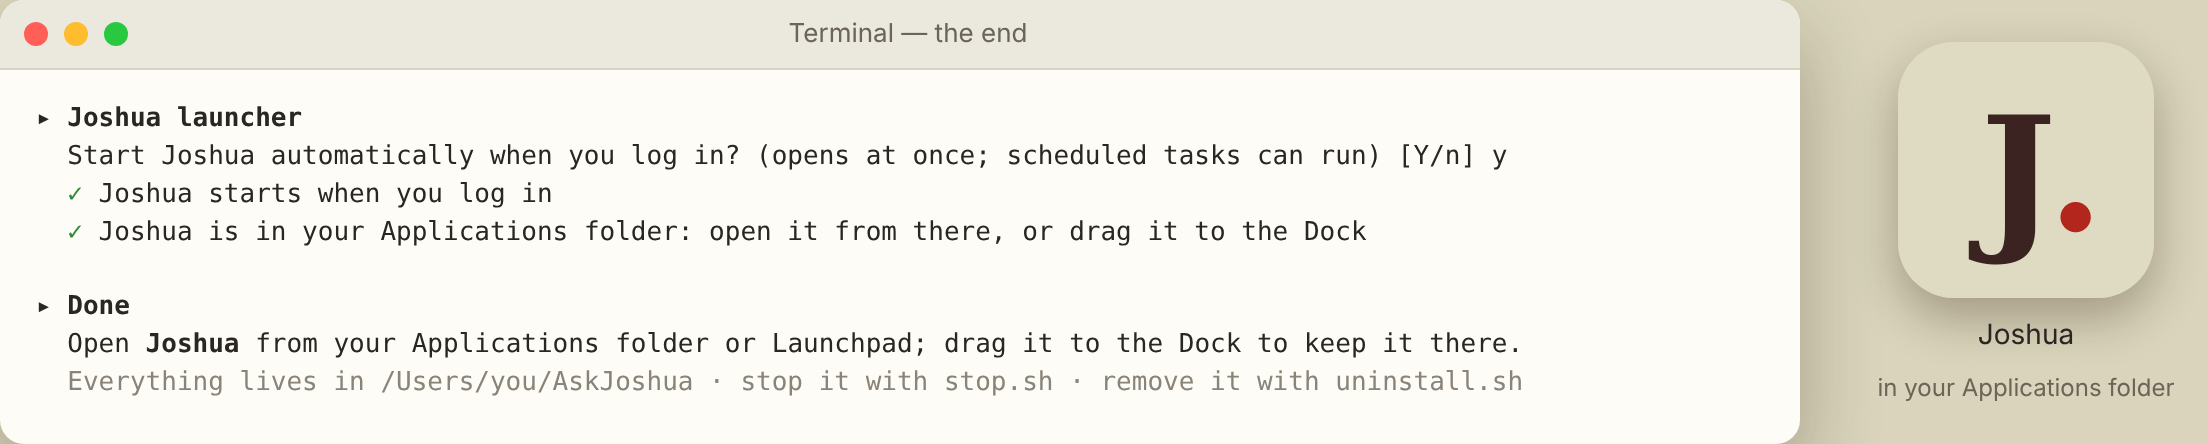
Potem instaluje Ollamę, silnik, który uruchamia modele, prywatną kopię Pythona, Joshuę i wybrane modele, i proponuje uruchamianie Joshui przy logowaniu, żeby otwierał się od razu, a zaplanowane zadania mogły się uruchamiać. Na Macu Joshua to osobna aplikacja w folderze Aplikacje, z własnym oknem i ikoną w Docku; na Linuksie otwiera się we własnym oknie z menu aplikacji. Wszystko inne jest w jednym folderze, ~/AskJoshua, z plikiem uninstall.sh, który go usuwa.
Zanim zaczniesz. Instalacja trwa około 20 minut, prawie wyłącznie pobieranie, zależnie od połączenia i wybranych opcji. Na niektórych Macach macOS proponuje też instalację „Narzędzi wiersza poleceń dla programistów” Apple: pozwól jej się skończyć. Pierwsze oszacowanie czasu (czasem wiele godzin) jest błędne; zwykle trwa to 10–20 minut. Modele w chmurze wymagają konta Ollama: gdy instalator otworzy stronę logowania, wystarczy Continue with Google z twoim adresem Gmail. Nowe konta Ollama płacą za zużycie: doładuj kilka dolarów na ollama.com, zanim użyjesz modeli w chmurze. Modele lokalne są zawsze darmowe. Modele lokalne nie wymagają żadnego konta.
Wolisz przeczytać przed uruchomieniem? Otwórz install.sh: to prosty, skomentowany skrypt powłoki. Cały kod Joshui jest na GitHubie, na licencji AGPL.
| Pamięć | Model | Opcje |
|---|---|---|
| 8 GB | qwen3-vl 4B · około 3 GB | Głębokie rozumowanie. Obrazy nie są proponowane: potrzebują 16 GB. Na wolnym procesorze zalecany jest 4B nawet przy 16 GB. |
| 16–24 GB | qwen3-vl 8B · około 6 GB | Głębokie rozumowanie, obrazy (FLUX.2 klein), fine-tuning. |
| 32 GB+ | qwen3-vl 30B · około 20 GB | Wszystko, z większym i mądrzejszym modelem, jeśli chcesz. |
| Każdy komputer | Tylko modele w chmurze · około 1 GB | Dla komputerów za małych lub za starych na modele lokalne (Maki z Intelem, mniej niż 8 GB pamięci, mało wolnego miejsca) albo jeśli wolisz. Odpowiedzi przychodzą z serwerów Ollamy; rozmowy, pliki i pamięć zostają na twoim komputerze. Potrzebne są połączenie z internetem i konto Ollama z kilkoma dolarami środków na zużycie. |
| Mac z macOS 26 | 🍎 Apple Intelligence · już w Macu | Dodawany sam, przy każdym wyborze powyżej, gdy Apple Intelligence jest włączone (każdy Mac z M1 lub nowszym). Darmowy, prywatny i szybki, ale mały: bez narzędzi, krótkie rozmowy, więcej błędów. |
| Linux | dobierany według karty graficznej: 4B poniżej 7 GB, 8B od 7 GB, 30B od 22 GB | Obrazy od 12 GB, fine-tuning od 8 GB, na kartach NVIDIA. Bez karty 4B działa na procesorze, powoli. |