Installer
Joshua
curl -fsSL https://ask.joshua.earth/install.sh | bash
Collez-le dans le Terminal. Il faut un Mac avec puce Apple (M1 ou plus récent) ou un PC Linux, 8 Go de mémoire et 10 à 40 Go libres sur le disque. Sous Linux, une carte graphique NVIDIA le rend beaucoup plus rapide. Gratuit et ouvert.
Une ligne, quelques questions
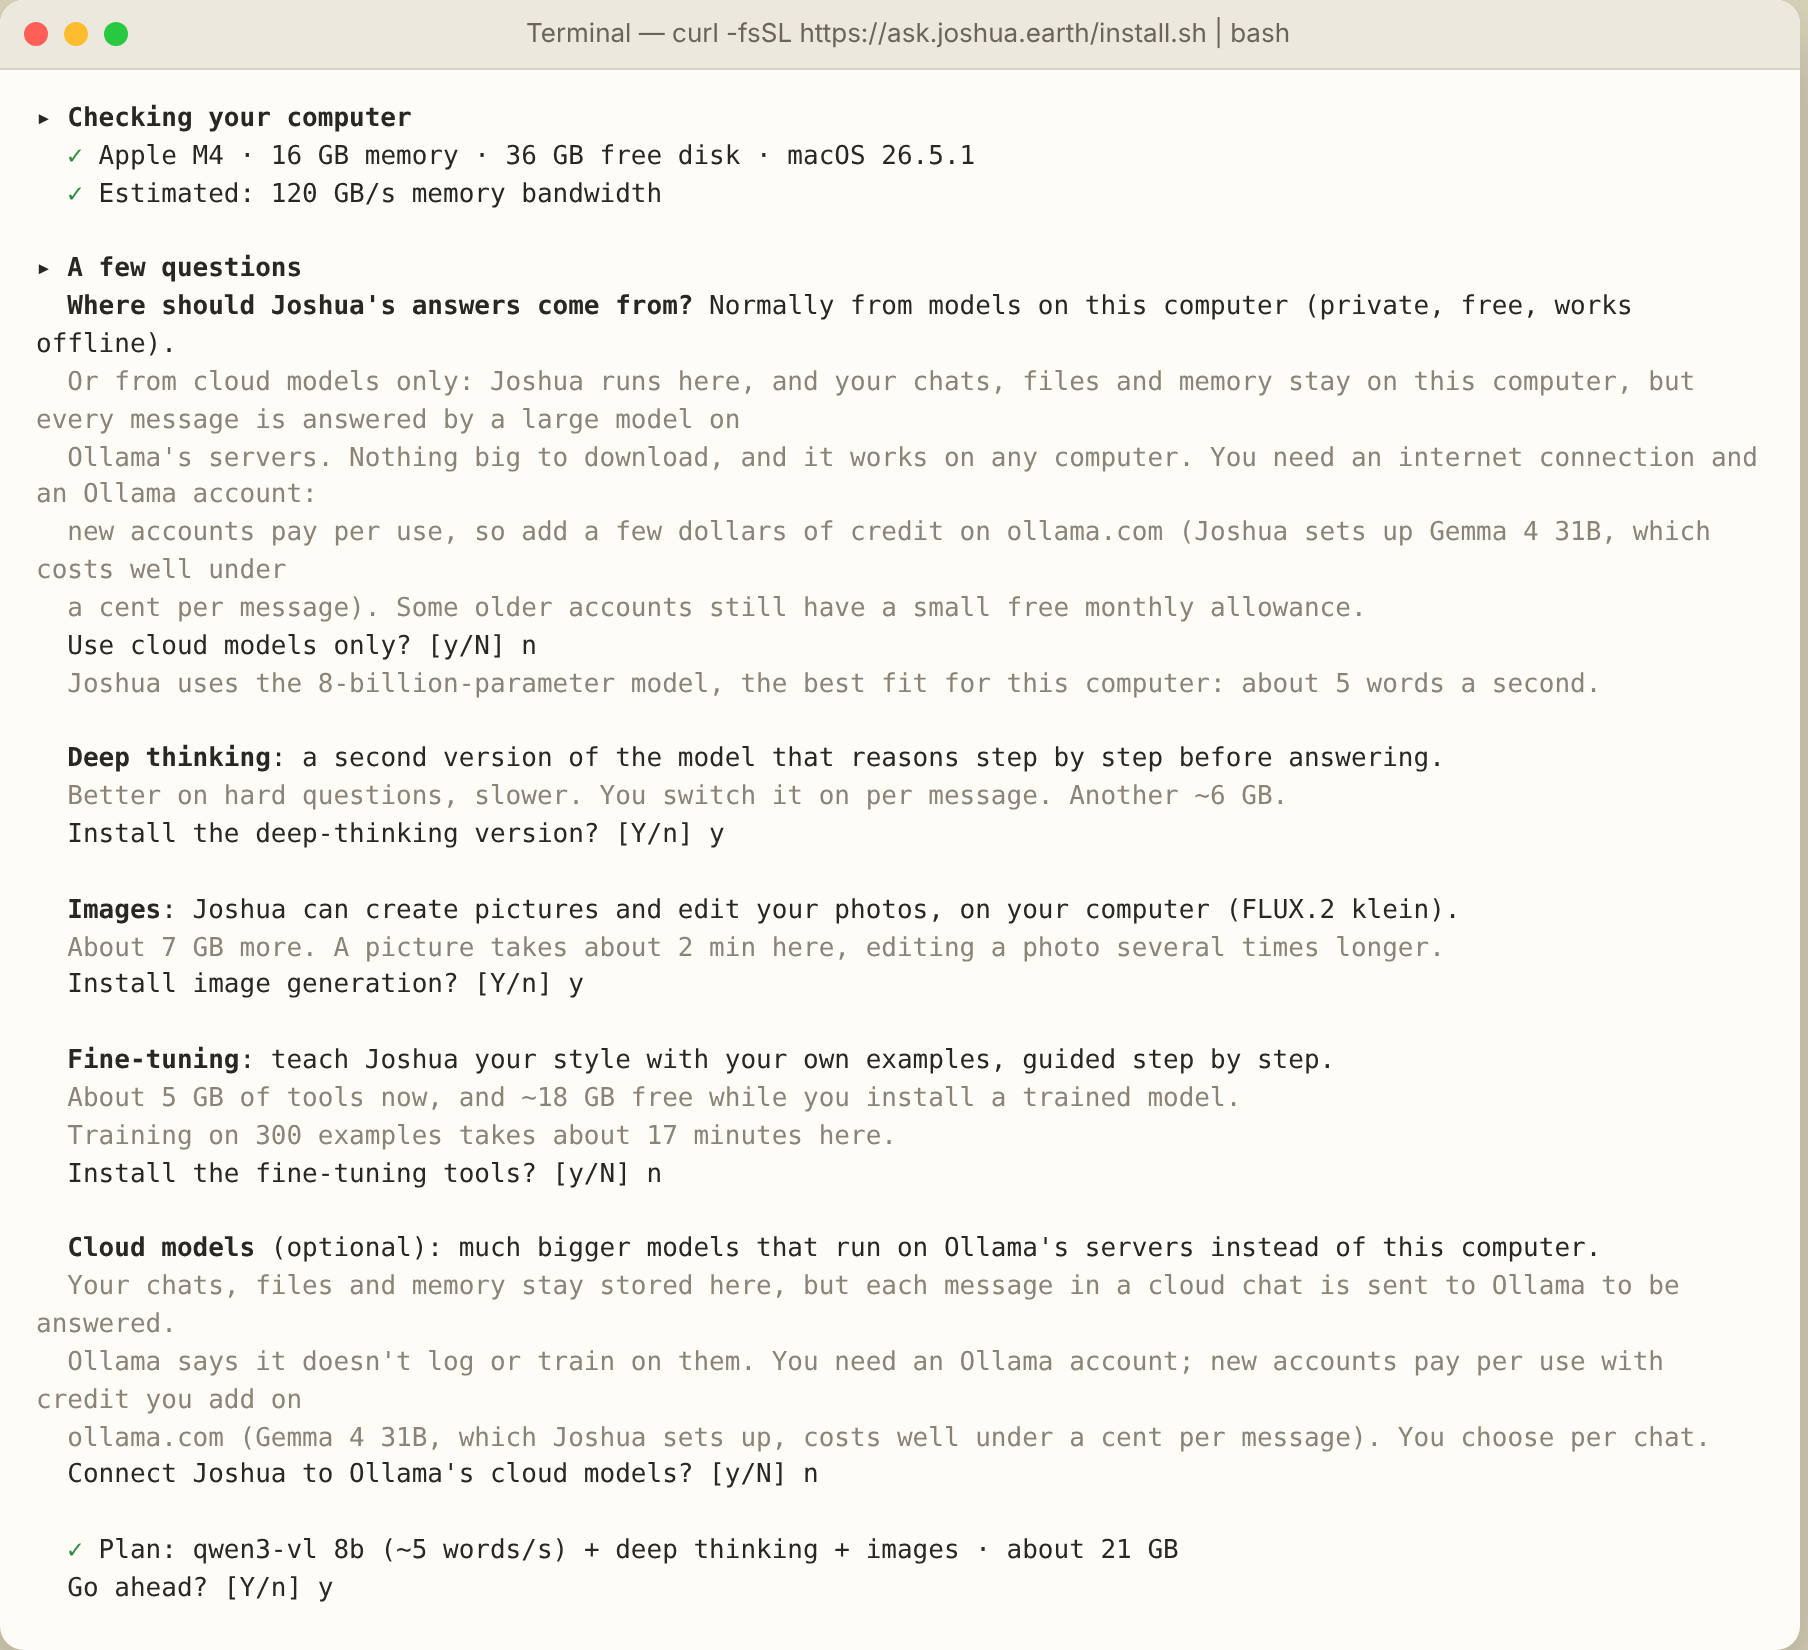
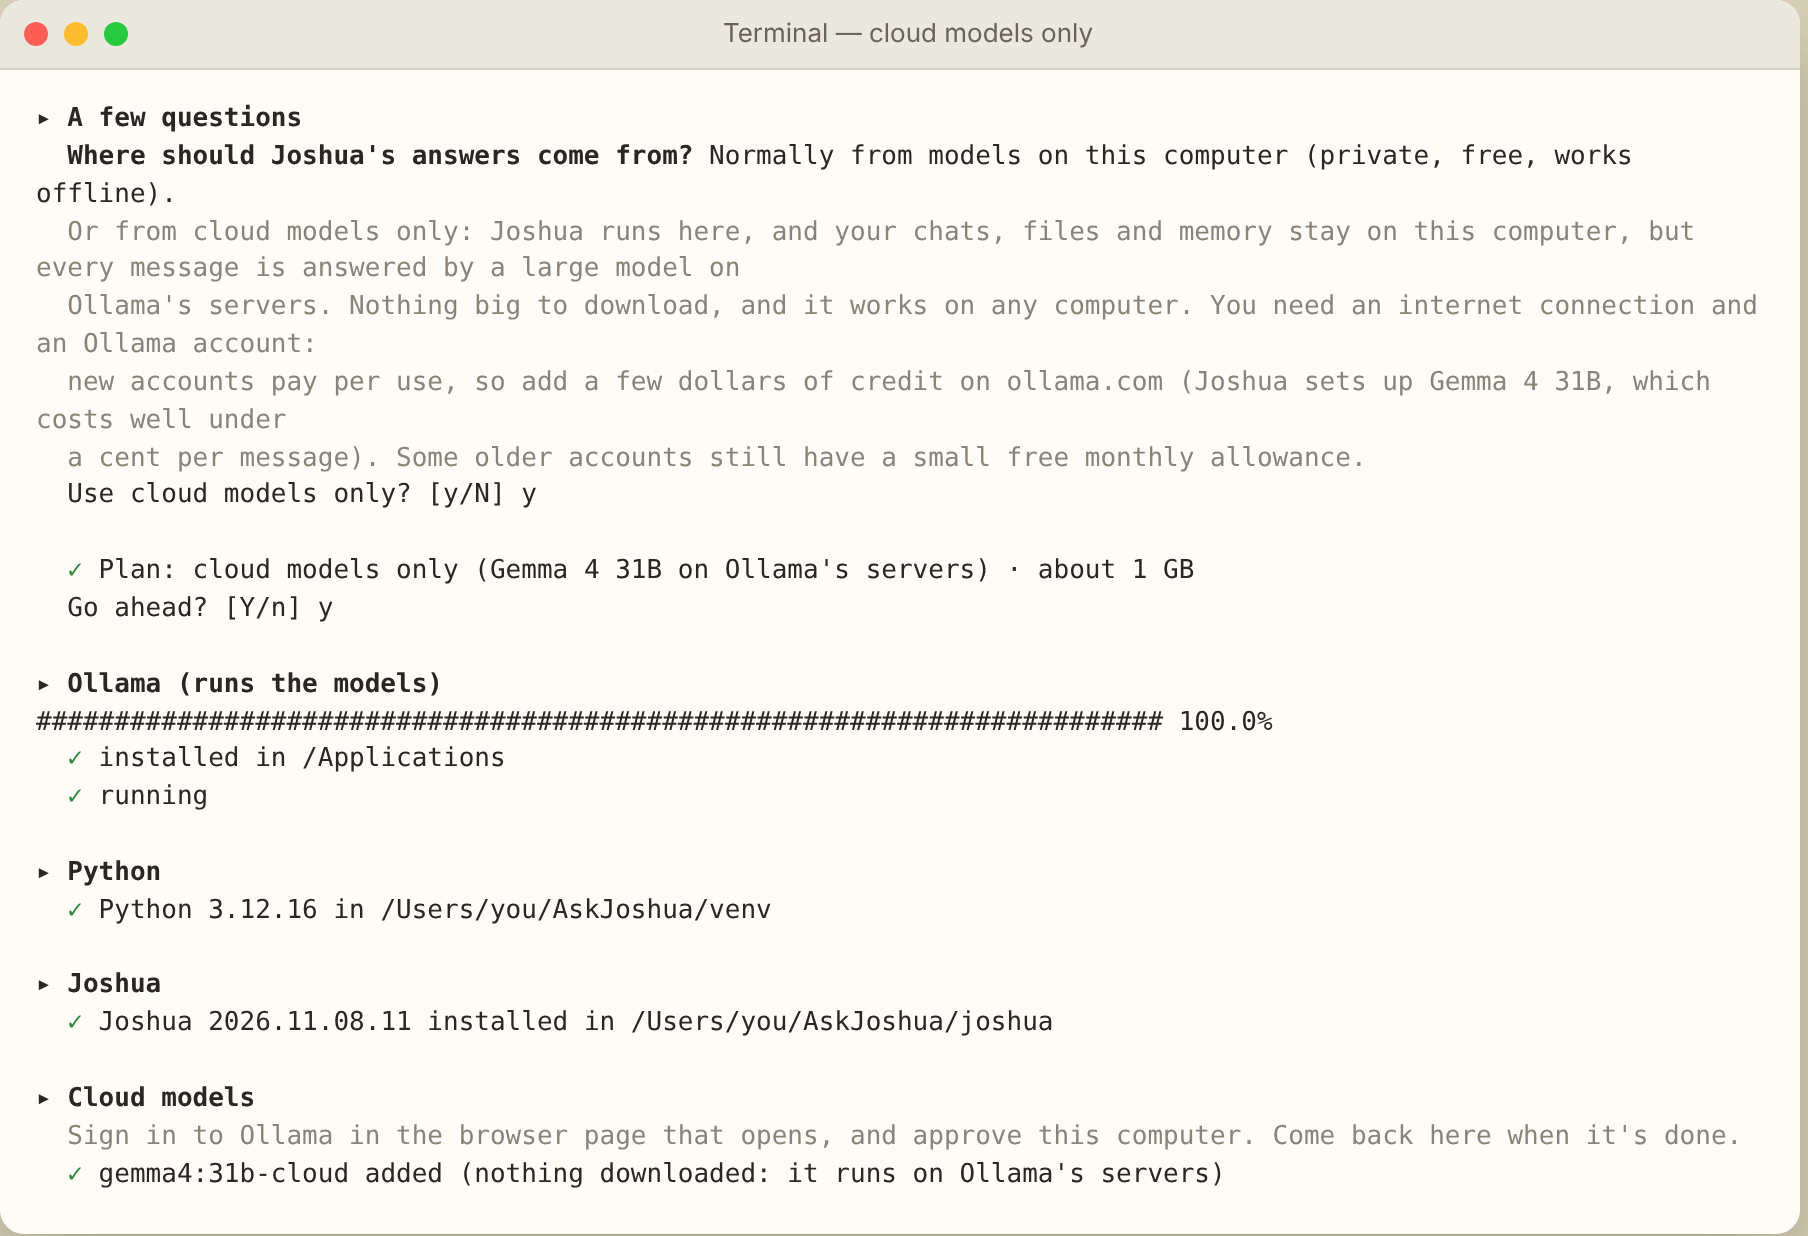
L'installateur regarde d'abord votre ordinateur : puce, carte graphique, mémoire, disque libre, et estime la vitesse de chaque modèle. Il vous demande si vous voulez le raisonnement approfondi, les images et le fine-tuning, ou seulement les modèles cloud, montre le plan et la place nécessaire, et attend votre oui.
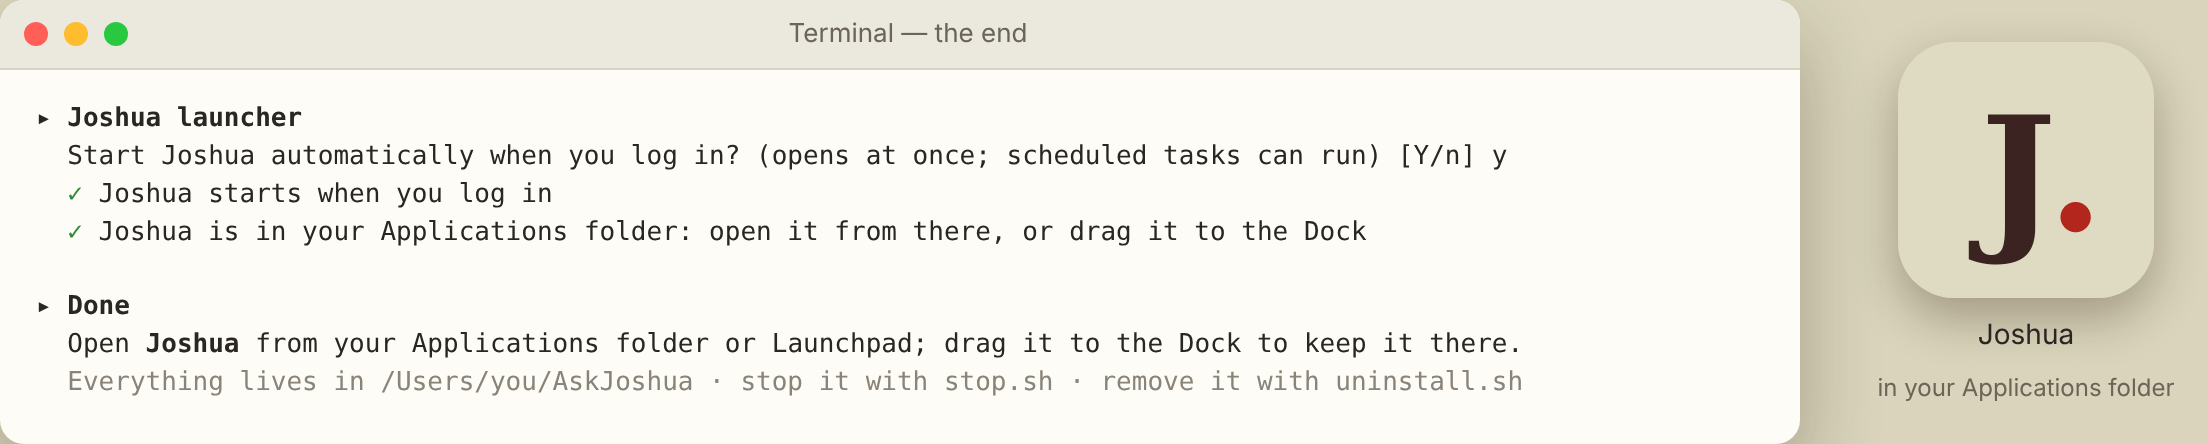
Puis il installe Ollama, le moteur qui fait tourner les modèles, une copie privée de Python, Joshua et les modèles choisis, et propose de lancer Joshua à l'ouverture de session, pour qu'il s'ouvre tout de suite et que les tâches programmées puissent se lancer. Sur Mac, Joshua est une appli à part dans le dossier Applications, avec sa fenêtre et son icône dans le Dock ; sous Linux, il s'ouvre dans sa fenêtre depuis le menu des applications. Tout le reste est dans un dossier, ~/AskJoshua, avec un uninstall.sh qui le supprime.
Avant de commencer. L'installation prend environ 20 minutes, presque entièrement en téléchargements, selon votre connexion et les options choisies. Sur certains Mac, macOS propose aussi d'installer les « Outils de ligne de commande pour développeurs » d'Apple : laissez-le finir. La première estimation de temps (parfois de nombreuses heures) est fausse ; il faut en général 10 à 20 minutes. Les modèles cloud demandent un compte Ollama : quand l'installateur ouvre la page de connexion, Continue with Google avec votre adresse Gmail suffit. Les nouveaux comptes Ollama paient à l'usage : ajoutez quelques dollars de crédit sur ollama.com avant d'utiliser les modèles cloud. Les modèles locaux sont toujours gratuits. Les modèles locaux ne demandent aucun compte.
Vous préférez lire avant d'exécuter ? Ouvrez install.sh : c'est un script shell simple et commenté. Tout le code de Joshua est sur GitHub, sous licence AGPL.
| Mémoire | Modèle | Options |
|---|---|---|
| 8 GB | qwen3-vl 4B · environ 3 Go | Raisonnement approfondi. Les images ne sont pas proposées : il faut 16 Go. Sur une puce lente, le 4B est conseillé même avec 16 Go. |
| 16–24 GB | qwen3-vl 8B · environ 6 Go | Raisonnement approfondi, images (FLUX.2 klein), fine-tuning. |
| 32 GB+ | qwen3-vl 30B · environ 20 Go | Tout, avec un modèle plus grand et plus intelligent si vous le voulez. |
| Tout ordinateur | Modèles cloud seulement · environ 1 Go | Pour les ordinateurs trop petits ou trop anciens pour les modèles locaux (Mac Intel, moins de 8 Go de mémoire, peu de disque libre), ou si vous préférez. Les réponses viennent des serveurs d'Ollama ; discussions, fichiers et mémoire restent sur votre ordinateur. Il faut une connexion internet et un compte Ollama avec quelques dollars de crédit à l'usage. |
| Mac sous macOS 26 | 🍎 Apple Intelligence · déjà dans le Mac | Ajouté tout seul, avec n'importe quel choix ci-dessus, quand Apple Intelligence est activée (tout Mac avec M1 ou plus récent). Gratuit, privé et rapide, mais petit : pas d'outils, discussions courtes, plus d'erreurs. |
| Linux | choisi selon la carte graphique : 4B sous 7 Go, 8B dès 7 Go, 30B dès 22 Go | Images dès 12 Go, fine-tuning dès 8 Go, sur cartes NVIDIA. Sans carte, le 4B tourne sur le processeur, lentement. |